Où en est la consommation de vos agents IA ?
Le prix du token n'a jamais été aussi bas : l'indice de référence est passé sous 1 $ le million fin août. Mais dans le même temps, les agents IA consomment déjà cinq fois plus de tokens que les humains. Combien de tokens vos agents consomment-ils aujourd'hui, à quel prix, et pour quel résultat ? Peu d'entreprises savent répondre précisément. C'est pourtant devenu la question centrale du passage à l'échelle.
TL;DR — EN BREF
- Le prix du token est au plus bas : l'indice de Silicon Data est passé sous 1 $ le million fin août 2026, et s'établissait à 0,94 $ le 24 octobre.
- Les agents consomment déjà cinq fois plus de tokens que les humains sur OpenRouter, et plus de 85 % de ces tokens viennent du cache.
- Prix divisé par deux, volume multiplié par cinq : sans changer d'architecture, la facture d'une même tâche est multipliée par 2,5.
- Avec du cache, le bon modèle à chaque étape et des boucles coupées, la même tâche coûte quatre fois moins.
- Le bon KPI n'est pas le prix du token, c'est le coût par tâche réussie.
Le contexte : un prix au plus bas, une consommation qui explose
Le LLM Token Expenditure Index de Silicon Data, qui suit le prix quotidien des tokens, est tombé à 0,97 $ le million de tokens le 31 août 2026. C'était la première fois qu'il passait sous 1 $ depuis son lancement, fin 2025, et ce niveau représentait moins de la moitié du pic atteint plus tôt dans l'été. Le 24 octobre, l'indice s'établissait à 0,94 $. Selon un analyste cité par CNBC, ce seuil met sous pression le modèle économique des grands laboratoires d'IA : le prix du token est désormais autant une variable de marché qu'une variable technique.
Côté usages, la bascule est déjà faite. Sur OpenRouter, l'une des principales plateformes de routage entre modèles, les agents ont dépassé les humains en février 2026. En août, ils représentaient 7 300 milliards de tokens, contre 1 400 milliards pour les usages humains (moyenne sur sept jours), soit environ cinq fois plus. Depuis février, la consommation des agents a été multipliée par 14, celle des humains par 2,8.
Ces chiffres portent sur le volume total d'une plateforme, pas sur le coût d'une tâche donnée. Mais ils dessinent une tendance claire : un agent qui travaille appelle le modèle bien plus souvent qu'un utilisateur qui pose une question.
Ce que révèle la consommation d'un agent
Un chiffre change la lecture : plus de 85 % des tokens consommés par ces agents proviennent du cache. L'agent passe l'essentiel de son temps à relire ce qu'il a déjà vu : son contexte, ses instructions, l'historique de la tâche. Or un token relu en cache est facturé une fraction du prix d'un token traité pour la première fois.
Regarder seulement le nombre de tokens ou le prix unitaire ne dit donc presque rien. Deux agents qui consomment le même volume peuvent avoir des factures très différentes, selon la part de cache, le modèle appelé à chaque étape et le nombre de boucles inutiles.
L'exemple illustratif ci-dessous compare trois façons d'exécuter une même tâche :
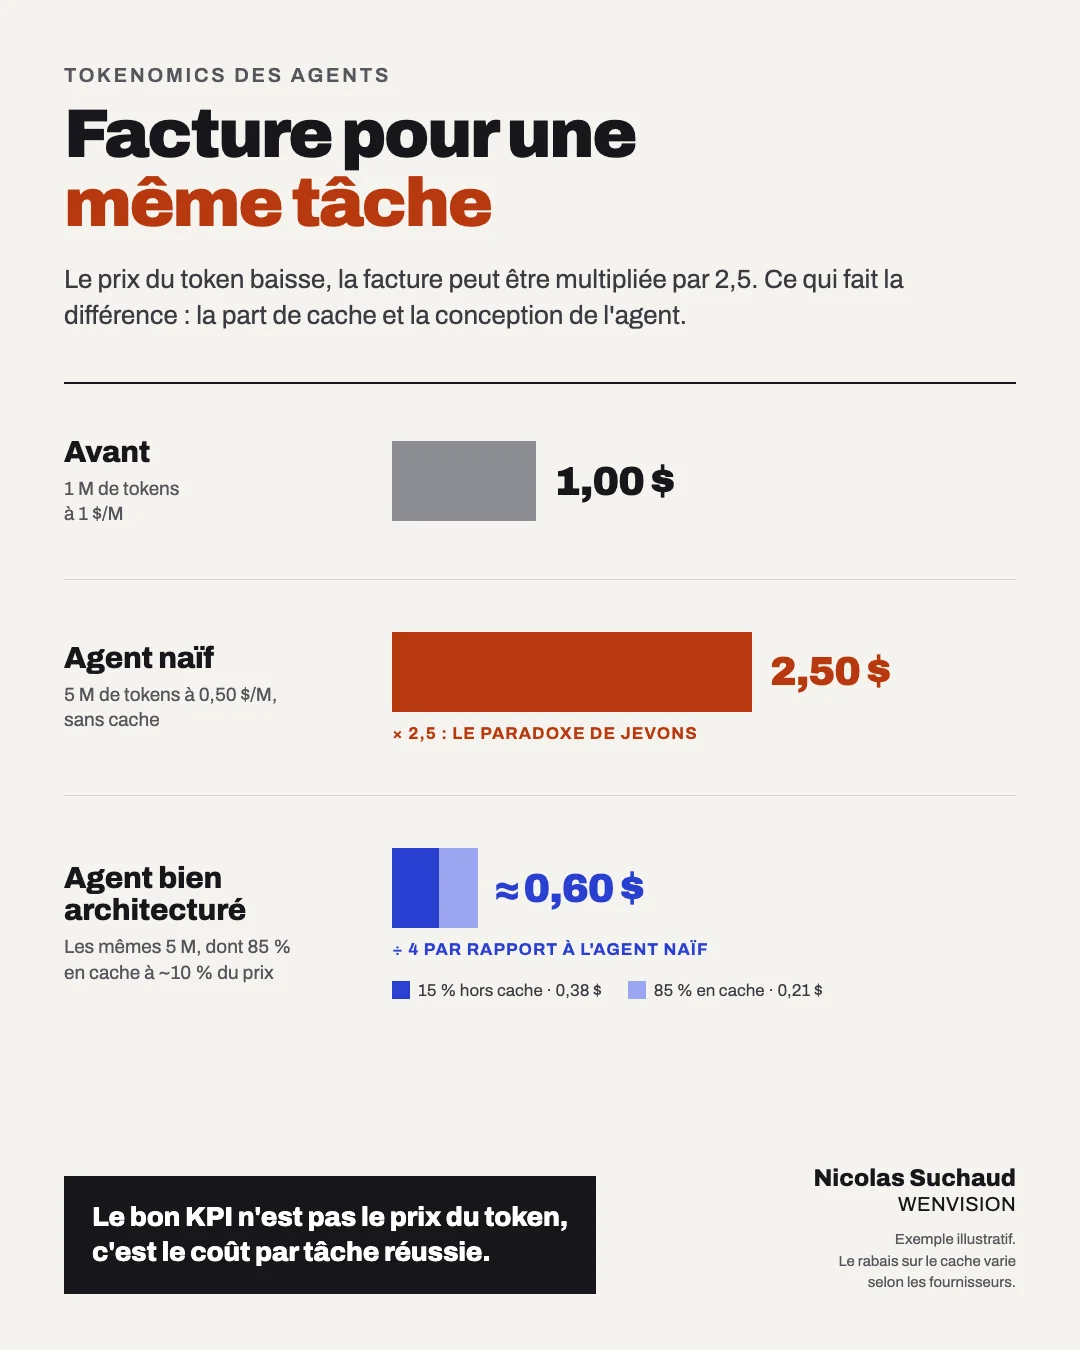
| Scénario | Consommation | Facture |
|---|---|---|
| Avant | 1 M de tokens à 1 $/M | 1,00 $ |
| Agent naïf | 5 M de tokens à 0,50 $/M, sans cache | 2,50 $ |
| Agent bien architecturé | les mêmes 5 M, dont 85 % en cache facturé environ 10 % du prix | environ 0,60 $ |
Exemple illustratif. Le rabais appliqué aux tokens en cache varie selon les fournisseurs.
Prix divisé par deux, volume multiplié par cinq : sans rien changer, la facture est multipliée par 2,5. C'est le paradoxe de Jevons appliqué à l'IA. Avec une architecture adaptée, la même tâche coûte quatre fois moins. Le coût n'a pas disparu, il s'est déplacé, du prix du token vers la conception des agents.
Faire le point : cinq questions à poser sur vos agents
Avant de décider d'étendre un programme agentique, il est utile de dresser un état des lieux de la consommation actuelle. Cinq questions suffisent à savoir où vous en êtes :
- Savez-vous combien de tokens chaque agent consomme, par tâche et par mois ? Une facture globale par fournisseur ne suffit pas à piloter.
- Quelle part de cette consommation passe par le cache ? Une part faible signale souvent un contexte rechargé inutilement à chaque appel.
- Chaque étape utilise-t-elle le bon modèle ? Le modèle le plus puissant n'est pas nécessaire pour classer, extraire ou reformuler.
- Combien de tâches échouent ou bouclent avant d'aboutir ? Les relances et les boucles sans progrès sont des tokens payés pour rien.
- Connaissez-vous le coût d'une tâche réussie, et qui le suit ? Sans responsable identifié, DSI, métier ou finance, personne n'arbitre.
Si plusieurs réponses manquent, la consommation de vos agents n'est pas encore pilotée : elle est subie.
Trois conséquences pour les programmes agentiques
- Changer d'indicateur. Le prix du million de tokens est un mauvais KPI. L'indicateur qui compte est le coût par tâche réussie : ce qu'il faut dépenser pour qu'un agent mène une tâche à bien, échecs et relances compris.
- Traiter le coût comme une exigence d'architecture. Mise en cache du contexte, routage de chaque étape vers le modèle adapté, coupure des boucles qui tournent sans progresser : ces choix se décident avant le premier sprint, pas une fois la facture arrivée. Ils s'accompagnent d'un suivi par cas d'usage, avec des seuils d'alerte.
- Construire des business cases réalistes. Un business case calibré sur des volumes humains sous-estime la consommation d'un agent. Il doit reposer sur des volumes agentiques mesurés en pilote, et être éprouvé avec un scénario où le prix du token remonte.
En résumé
La baisse du prix du token ne dit rien de ce que coûtent réellement vos agents. Le vrai statut se lit dans trois chiffres : le volume par tâche, la part de cache, et le coût d'une tâche réussie. Les entreprises qui les suivent dès aujourd'hui pourront passer à l'échelle sans mauvaise surprise. Le bon KPI n'est pas le prix du token, c'est le coût par tâche réussie.
Vous souhaitez faire le point sur la consommation de vos agents ? Échangeons sur vos cas d'usage.
Sources
- Quartz, « AI model pricing is hitting record lows, squeezing revenue for frontier labs », 1er septembre 2026.
- Silicon Data, « LLM Token Expenditure Index (SDLLMTK) », relevé du 24 octobre 2026.
- Tom's Hardware, « AI agents use 5x more tokens than humans… », 3 octobre 2026 (données OpenRouter citées par a16z).
Continuer votre exploration
Découvrez d'autres articles du cluster ia-entreprise-roi dans l'univers Intelligence Artificielle